Контекстное окно нейросети: что это и почему не растёт
Я объяснял знакомому, как работать с контекстом, и прямо посреди урока задался вопросом: а какое сейчас контекстное окно у нейронок? Оказалось, оно не сдвинулось. Миллион токенов — такое окно Gemini показал ещё в феврале 2024 года.
- Автор
- Михаил Белокоз
- Опубликовано
- Чтение
- 18 минут
На 29 октября 2026 года контекстное окно у флагманских нейросетей — около миллиона токенов: у Claude Opus 5.5, GPT-6 Astra, Gemini 4 Argon и DeepSeek V4. Столько же Gemini показал ещё в 2024-м, и с тех пор рост встал. В чатах окно бывает меньше: в бесплатном ChatGPT — 27 тысяч токенов, около 12 страниц. Заполнится окно — нейросеть сама сожмёт переписку и потеряет детали, а надёжно она работает на длине куда меньше заявленной.
Содержание
- Что такое контекстное окно простыми словами?
- Какой размер контекстного окна у ChatGPT, Claude, Gemini и DeepSeek?
- Как росло контекстное окно: от 8 тысяч до миллиона
- Почему контекстное окно перестало расти?
- Что будет, когда контекстное окно заполнится?
- Эффективное контекстное окно: почему нейросеть тупеет раньше предела
- Чем контекстное окно отличается от памяти нейросети?
- Итог
- Кому подойдёт и с чего начать
Что такое контекстное окно простыми словами?
Контекстное окно — всё, что нейросеть держит в голове в одном диалоге: твои сообщения, свои ответы, файлы и скрытые инструкции. Меряют его в токенах, и на 29 октября 2026 года у флагманских моделей это около миллиона токенов.
Нейронка держит в голове только сессию. Всё, что есть в сессии, лежит в её контекстном окне, и с этим она работает. Чего в сессии нет, того для неё не существует. И самое важное: окно ограничено.
В окно входит всё, что уходит в модель с запросом: системные инструкции, каждое сообщение, файлы и картинки, результаты инструментов и их описания. Туда же идёт и ответ модели вместе с её рассуждениями (Anthropic). Задал вопрос — модель заново читает всё окно и только потом отвечает.
Токен — кусочек текста: слово или часть слова. Для английского OpenAI считает так: токен — это примерно 4 символа или три четверти слова (OpenAI). Русский текст тяжелее. По замеру автора donseo на Хабре (1 октября 2026 года, четыре небольших текста) у GPT, Gemini, Grok и GLM русский «весит» на 18–23% больше английского того же смысла, у DeepSeek — на 38%, у Claude Opus 5 — почти втрое. У GigaChat и YandexGPT наоборот: русский занимает меньше токенов, чем английский перевод (Хабр).
Миллион токенов — это примерно 50 000 строк кода или 8 романов средней длины на английском (Google). Русского текста в то же окно влезет меньше.
Сколько окна занято с первого сообщения
Часть окна занята тем, чего ты не видишь. Я открыл новый чат в Claude Code, написал «тест» — и 8% окна уже нет:
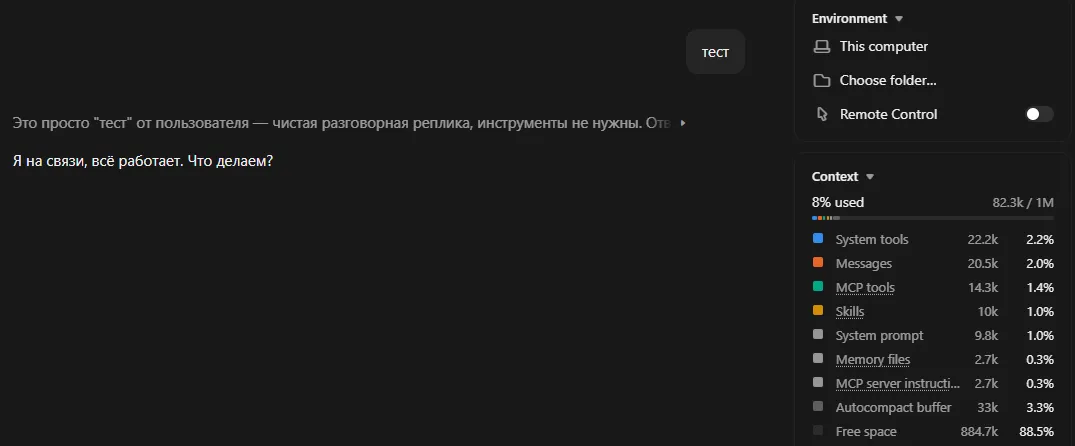
Из 82 тысяч токенов около 62 тысяч — служебное: системные инструменты, инструменты подключённых сервисов (MCP) и их инструкции, скиллы, системный промпт и файлы памяти. Остальное — сама переписка. Ещё 33 тысячи Claude Code держит в запасе под автосжатие, о нём ниже. На уроке у меня на старте так же сразу ушло 10%.
У других нейросетей окно тоже занято невидимыми инструкциями — чтобы модель совсем ерунду не несла. В апреле 2026 года в инструкциях Codex, кодового агента OpenAI, нашли строку: никогда не говори о гоблинах, гремлинах, енотах, троллях, ограх, голубях и других существах, если это не относится к запросу (Simon Willison). OpenAI объяснила: начиная с GPT-5.1 модели всё чаще вставляли гоблинов в метафоры, так сказалось обучение «занудной» личности Nerdy. GPT-5.5 начали обучать раньше, чем нашли причину, поэтому в Codex добавили запрет (OpenAI, 29 апреля 2026). Такая строка тоже лежит в окне и занимает в нём место.
Какой размер контекстного окна у ChatGPT, Claude, Gemini и DeepSeek?
На 29 октября 2026 года у Claude Opus 5.5, GPT-6 Astra, Gemini 4 Argon и DeepSeek V4 окно около миллиона токенов, у Grok 4.7 — 500 тысяч, у моделей Яндекса и Сбера — 128 тысяч. Это окно модели у разработчиков. В чате оно бывает в десятки раз меньше.
Окно модели — то, что разработчики получают через API:
| Модель | Окно, токенов | Вышла |
|---|---|---|
| Claude Opus 5.5 | 1 000 000 | сентябрь 2026 |
| GPT-6 Astra | 1 050 000 | сентябрь 2026 |
| Gemini 4 Argon | 1 048 576 | октябрь 2026 |
| DeepSeek V4-Pro | 1 000 000 | апрель 2026, превью |
| Kimi K3 | 1 048 576 | июль 2026 |
| Qwen3.8-Max | 1 000 000 | август 2026 |
| GLM-5.3 | 1 000 000 | август 2026 |
| Grok 4.7 | 500 000 | сентябрь 2026 |
| GigaChat 3 Ultra | 128 000 | июль 2026 |
| Alice AI LLM | 131 072 | — |
Почти все модели 2026 года упёрлись в один и тот же миллион. Какая из них при этом умнее — в рейтинге нейросетей.
В чатах и приложениях окно своё, и часто меньше:
| Чат | Бесплатно | Платно |
|---|---|---|
| ChatGPT, обычный режим | 27 тыс. — около 12 страниц | 54 тыс. в Go и Plus, 128 тыс. в Pro |
| ChatGPT, режим с рассуждениями | «меняется» | 256 тыс. в Go и Plus, 400 тыс. в Pro |
| Gemini | 32 тыс. | 128 тыс. в AI Plus, 1 млн в AI Pro и Ultra |
| Claude | в справке нет | 1 млн у Opus 5 и 5.5, Sonnet 5 и 5.5, Haiku 5.5 и Fable 5.1; 500 тыс. у Fable 5, Opus 4.6–4.8 и Sonnet 4.6 |
Источники: тарифы ChatGPT, лимиты Gemini, справка Claude на 29 октября 2026 года. DeepSeek пишет, что окно в миллион — стандарт во всех его официальных сервисах (DeepSeek, 24 апреля 2026). Размер окна в чатах Алисы и GigaChat я у Яндекса и Сбера не нашёл.
Самый большой разрыв у ChatGPT: в бесплатном чате окно почти в 40 раз меньше, чем у GPT-6 Astra в API. И даже это окно не всё твоё. На странице тарифов OpenAI прямо пишет: «Часть, доступная для ввода пользователем, меньше, чем всё окно, поскольку пространство также используется для системных инструкций (включая инструменты и персональные настройки), памяти (если она включена) и внутренней обработки (…)».
Как я каждый день работаю с нейросетями и агентами — пишу в канале. МАКС · ВК
Как росло контекстное окно: от 8 тысяч до миллиона
Меньше чем за год окно выросло с 8 тысяч токенов у GPT-4 весной 2023-го до миллиона у Gemini 1.5 Pro в феврале 2024-го. Летом 2024-го Google открыла 2 миллиона. А потом рост встал: на октябрь 2026 года у флагманов снова миллион.
| Когда | Модель | Окно, токенов |
|---|---|---|
| март 2023 | GPT-4 | 8 тыс., ограниченно — 32 тыс. |
| май 2023 | Claude | 100 тыс. |
| ноябрь 2023 | GPT-4 Turbo | 128 тыс. |
| ноябрь 2023 | Claude 2.1 | 200 тыс. |
| февраль 2024 | Gemini 1.5 Pro | 1 млн — в тестовом доступе |
| июнь 2024 | Gemini 1.5 Pro | 2 млн — для всех разработчиков |
| апрель 2025 | GPT-4.1 | 1 млн |
| сентябрь 2025 | Grok 4 Fast | 2 млн |
| май 2026 | Grok на 2 млн сняли с API | — |
| сентябрь — октябрь 2026 | Claude Opus 5.5, GPT-6 Astra, Gemini 4 Argon | 1–1,05 млн |
С середины 2023-го до середины 2025-го самое длинное окно росло примерно в 30 раз в год (Epoch AI, июнь 2025). Помню, как все тогда восторгались: «О боже, Gemini выпустил версию с контекстным окном в миллион токенов!» Прошло больше двух с половиной лет, и миллион из рекорда превратился в потолок.
Почему контекстное окно перестало расти?
Длинное окно дорогое, а пользоваться им модели толком не умеют: на сотнях тысяч токенов качество падает у всех. Компании выбрали делать миллион дешевле и умнее, а не растить окно дальше.
Сейчас все работают над тем, чтобы нейронка якобы думала умнее. А окно стоит, и причин три.
Длинный запрос дорогой. На каждый ответ модель обрабатывает всё окно, и чем оно длиннее, тем больше вычислений и памяти видеокарт. Разработчики берут за это доплату. За GPT-6 Astra после 272 тысяч токенов в запросе OpenAI берёт вдвое больше за вход и в полтора раза больше за ответ (OpenAI). Grok 4.7 после 200 тысяч дорожает вдвое (xAI), Claude Haiku 5.5 после 100 тысяч — в пять раз (Anthropic).
Качество на длине падает. Модель с окном в миллион не значит модель, которая хорошо работает на миллионе. Об этом — следующий раздел.
Деньги ушли в «дешевле и умнее». DeepSeek хвалится не окном, а тем, что V4-Pro на миллионе токенов тратит 27% вычислений и 10% памяти от прошлой V3.2 (Hugging Face). У Claude Opus 5.5 повторное чтение того же контекста из кэша стоит $0,20 за миллион токенов вместо $4 (Anthropic).
Окна даже сокращаются. У Gemini 1.5 Pro было 2 миллиона, у Gemini 4 Argon — миллион. Модели Grok на 2 миллиона сняли с API 15 мая 2026 года, у нового Grok 4.7 — 500 тысяч. У GPT-6.1 Sol в API 1,05 миллиона, а в Codex и ChatGPT Work по умолчанию — 500 тысяч (OpenAI).
Окна на 10 миллионов токенов и больше анонсировали, но массово доступного окна больше 1,05 миллиона на октябрь 2026 года нет. Qwen-Long от Alibaba формально принимает 10 миллионов токенов, но обычным запросом — до миллиона, остальное — загрузкой файлов, а ответ — до 8 тысяч токенов (Alibaba Cloud).
Исследования есть. Архитектура Titans от Google работает на окнах больше 2 миллионов токенов, но пока в научной статье, а не в продукте (Google Research). Чаще компании идут другим путём: не растят окно, а учат модель сжимать то, что в нём уже лежит. Такое серверное сжатие переписки есть в API у OpenAI и, пока в бете, у Anthropic (OpenAI, Anthropic).
Что будет, когда контекстное окно заполнится?
Нейросеть сама сожмёт переписку: коротко перескажет ранние сообщения и пойдёт дальше. Отдельно об этом она не предупреждает, а в пересказе часть деталей может потеряться.
Если ты думаешь, что нейросеть безграничная, то ошибаешься. У неё есть контекстное окно, и как только оно забьётся, она его сама сожмёт и даже тебя не предупредит: деваться ей некуда.
- Claude в чате на платных тарифах, когда разговор подходит к пределу окна, пересказывает ранние сообщения, чтобы освободить место. Для этого должно быть включено выполнение кода. Всё, что ты заметишь, — изредка надпись «organizing its thoughts». Полная история чата при этом сохраняется, и Claude может к ней обратиться (справка Anthropic).
- Claude Code сжимает разговор сам, примерно на 967 тысячах токенов у моделей с окном в миллион (Anthropic). Отсюда и 33 тысячи запаса на моём скриншоте.
- Gemini в справке честно пишет: если превысить окно, ответы могут не учитывать всё, что ты дал, и упускать детали (Google).
- ChatGPT: официального описания, что происходит при переполнении, я у OpenAI не нашёл.
Сжатие похоже на пересказ своими словами. Было 99%, нейросеть ужала, стало 20%, можно продолжать. Но из прошлой переписки она что-то выкинула, что-то переписала своими словами, а что-то упростила. Причём пересказывает она в худший момент: Anthropic прямо пишет, что при сжатии модель глупее всего, потому что окно уже забито и внимание размазано по всем токенам (Anthropic). Важный контекст теряется, и если вести диалог до бесконечности, рано или поздно накопятся галлюцинации. От разговора остаётся что-то вроде «рыбалка, играть диджеем, подштанники». Так было раньше, сейчас модели в этом получше.
Как было у меня
Раньше сжатие замечалось очень сильно. В последнее время я до сжатия особо не дохожу, поэтому не замечаю.
Очевидно, Anthropic над этим работает. Они прекрасно понимают, что большая часть пользователей вообще не знает, что такое контекст, и сжатие у них происходит постоянно. Поэтому им пришлось решать проблему галлюцинаций при сжатии, и она уже достаточно хорошо решена.
На больших задачах окно забивается быстро: Claude начинает думать, и 50–70% уходит за пару промптов. Тогда я делаю handoff и /clear — что это такое, в статье про лимиты.
Эффективное контекстное окно: почему нейросеть тупеет раньше предела
Эффективное окно — длина, на которой модель ещё отвечает надёжно, и оно меньше заявленного. В тесте Google на обход графа у всех флагманов на длине от 256 тысяч до миллиона токенов результат ниже, чем до 128 тысяч: у Claude Opus 5.5 — 66,8% против 90,6%.
Сама Anthropic пишет: чем больше токенов в окне, тем хуже точность и способность вспомнить нужное, и называет это «гниением контекста», context rot (Anthropic). Это как считать в уме, пока рядом кто-то играет и орёт: думать мешает шум в голове.
Свежий замер — из карточки Gemini 4 Argon от 13 октября 2026 года. Задача — обойти в ширину большой граф, описанный в тексте, оценка — F1:
| Модель | До 128 тыс. токенов | 256 тыс. — 1 млн |
|---|---|---|
| Gemini 4 Argon | 99,7% | 84,2% |
| GPT-6 Astra | 98,7% | 71,8% |
| Claude Fable 5.1 | 91,4% | 65,0% |
| Claude Opus 5.5 | 90,6% | 66,8% |
Тест проводила сама Google и сравнивала свою модель с конкурентами, а обход графа — одна узкая задача, не «качество вообще» (Google DeepMind). Но падение на длине видно у всех.
То же показывали исследования прошлых поколений:
- Lost in the Middle, 2023. Модели лучше всего находят нужное в начале и в конце текста, а в середине заметно хуже (arXiv).
- NoLiMa, февраль 2025. Из 13 моделей, которые заявляли окно от 128 тысяч, 11 уже на 32 тысячах токенов опустились ниже половины своего результата на коротком тексте. GPT-4o — с 99,3 до 69,7% (arXiv).
- Chroma, июль 2025. 18 моделей, среди них GPT-4.1, Claude 4 и Gemini 2.5: чем длиннее вход, тем менее надёжно они работают (Chroma).
Даже Google про свой миллион пишет аккуратно: один факт в длинном тексте модель находит примерно в 99% случаев, а если фактов несколько, точность ниже (Google).
Общего порога нет, у каждой модели и задачи он свой. Есть мнение, что после 20% окна контекст начинает гнить и выше лучше не заходить, если хочешь сделать задачу. Но на больших задачах 20% забиваются очень быстро, так что эффективное окно проверяется только на своих задачах.
Чем контекстное окно отличается от памяти нейросети?
Окно — то, что модель видит прямо сейчас. «Память» в ChatGPT и Claude — заметки и поиск по прошлым чатам: чтобы модель их учла, они должны попасть в то же окно. Долгой памяти, как у человека, у модели нет.
У человека есть быстрая память и долгая. Скажи взрослому «GTA Vice City» — и у него по одной фразе из долгой памяти подгрузится карта и всё, что угодно. Маленький ребёнок, который не играл, переспросит: «Это типа Roblox?»
А у нейронки ключевой момент: у неё есть только быстрая память. Долгой памяти у неё нет, пока что. Всё, что она подгружает, она подгружает кусочками в своё окно.
Так устроена и «память» в чатах. ChatGPT хранит сохранённые заметки и может опираться на прошлые разговоры (OpenAI), но место под эту память берётся из того же окна — это видно в цитате со страницы тарифов выше. Claude сохраняет заметки по темам, а прошлые чаты ищет инструментом, и найденное, как любой результат инструмента, занимает окно текущего разговора (справка Anthropic).
По объёму быстрой памяти модель человека обходит: человек удерживает в уме примерно четыре элемента (Cowan, 2001) — сравни с миллионом токенов. Но у нас есть долгая память и сон: во сне свежие воспоминания укладываются в долгую память (Diekelmann и Born, 2010).
У человека контекстное окно, можно сказать, бесконечное, длиной в жизнь. Мы спим, отвлекаемся, и всё укладывается. После десятка встреч подряд можно полчаса полежать, восстановиться и пойти дальше работать. А нейронка так не может: у неё окно размером в сессию, и когда оно кончается, она сжимает накопленное сама.
Итог
1 млн токенов
Окно не растёт с 2024 года: все работают над тем, чтобы нейросеть думала умнее, а миллион токенов так и остался потолком. Нейронка — пока штука, которая умеет генерировать следующую букву и держать в голове миллион токенов. Всё остальное — инструменты и контекст. Машина как была с двигателем внутреннего сгорания, так и осталась.
- Окно флагманов
- 1 млн токеновClaude Opus 5.5, GPT-6 Astra, Gemini 4 Argon, DeepSeek V4
- Рекорд 2024 года
- 2 млну Gemini 1.5 Pro, у Gemini 4 Argon — миллион
- Новый чат у меня
- 8%82 тысячи токенов после одного слова «тест»
- Кому
- тем, кто думает, что нейросеть помнит весь разговор
Кому подойдёт и с чего начать
- Пишешь в бесплатном ChatGPTПомни, что в обычном режиме в окно влезает около 12 страниц: документ длиннее нейросеть целиком не увидит.
- Работаешь в Claude CodeНабери /context и посмотри, сколько окна занято и чем.
- Выбираешь нейросеть под длинные текстыСмотри не на миллион в анонсе, а на окно в своём тарифе и на тесты на длину в карточке модели.